训练、推理、边缘三场景芯片盘点:带宽与功耗差异项全解析
按训练、推理与边缘三类场景整理公开参数,盘点不同芯片在带宽与功耗上的差异项,说明并排对比时如何识别关键取舍,避免选型误判。
人人看球产品与方案栏目按训练、推理与边缘场景整理公开参数,支持多方案并排对比与差异项高亮,帮助读者理解不同芯片在算力、带宽与功耗上的取舍逻辑。所有参数均来自公开资料整理,便于横向阅读与选型参考。
按训练、推理与边缘三类场景整理,先看整体定位,再进入参数对比
面向模型预训练与大规模微调,强调浮点算力与显存带宽的配比,适合长时间、高吞吐的计算任务。
面向在线服务与批量推理,重点在单位功耗下的吞吐表现,兼顾首包延迟与显存容量。
面向终端与边缘节点部署,功耗与散热约束更紧,强调能效比与稳定的持续输出能力。
差异项以高亮标出,方便快速定位不同方案在算力、带宽与功耗上的取舍
| 对比维度 | 训练型 A | 训练型 B | 推理型 C | 边缘型 D |
|---|---|---|---|---|
| 典型算力 | 320 TFLOPS | 280 TFLOPS | 160 TFLOPS | 48 TOPS |
| 显存带宽 | 2.0 TB/s | 1.8 TB/s | 1.2 TB/s | 256 GB/s |
| 显存容量 | 80 GB | 64 GB | 48 GB | 16 GB |
| 整卡功耗 | 400 W | 350 W | 150 W | 35 W |
| 互联带宽 | 600 GB/s | 600 GB/s | 256 GB/s | 64 GB/s |
| 能效比取向 | 算力优先 | 算力优先 | 吞吐优先 | 功耗优先 |
从实际部署约束出发,理解参数背后的取舍逻辑
训练阶段计算密度高,若带宽跟不上,算力会长期处于等待状态。选型时应先看两者比值,再考虑显存容量是否满足批次需求。
在线服务看重首包延迟,批量任务看重整体吞吐。同一方案在不同批次策略下表现差异明显,需要结合实际请求分布来判断。
边缘节点往往没有主动散热条件,功耗上限直接决定机箱形态与部署密度。此时能效比与持续输出稳定性比峰值算力更重要。
把公开参数落到具体约束上,逐层缩小候选范围
先确认是训练、推理还是边缘部署,不同场景的核心指标完全不同,避免用同一套标准横向比较。
梳理机房供电、散热条件与机位空间,把功耗和体积作为第一层筛选条件,快速排除不合适的方案。
在剩余候选中并排比较算力、带宽与显存容量,重点看比值是否匹配,而不是单纯比较单项峰值。
结合持续负载下的能效比与扩展方式,评估长期运行成本,最终确定方案组合与配比。
近期读者关注度较高的方案与参数解读内容
在手机与电脑上同步查看赛程、比分与赛事解读,随时翻阅产品与方案栏目的参数对比内容。
参数解读、场景分析与选型经验,持续更新
按训练、推理与边缘三类场景整理公开参数,盘点不同芯片在带宽与功耗上的差异项,说明并排对比时如何识别关键取舍,避免选型误判。
围绕边缘侧推理与轻量训练场景,盘点公开参数中算力、带宽与功耗的常见披露口径,说明并排对比时哪些差异项值得优先关注,帮助读者建立可复用的读表方法。
封装不只是把芯片装进盒子。按互连距离从长到短盘点五种主流封装形式,说清各自适合什么芯片、卡在哪一步,帮你在选型时少走弯路。
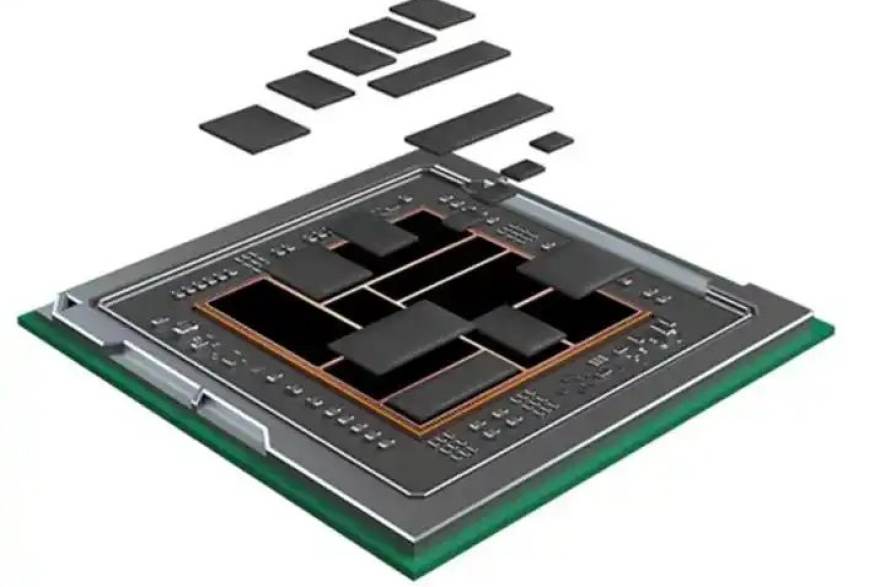
训练芯片的制程选择不只是追新。本文盘点三类制程节点选择背后的成本结构、量产节奏与封装配合逻辑,给出适配判断框架。
训练集群拼算力密度,推理集群拼能效与调度。本文从先进封装、显存带宽与集群互联三个层面拆解AI芯片部署的能效账本,帮读者理解产业节奏背后的工程逻辑。
验证工程师苏念禾回顾推理芯片从成熟制程向更先进节点迁移的过程,讲述功耗、良率与上市节奏之间的工程权衡,为读者理解制程节点动态提供一线视角。
从传统单片封装到Chiplet多die组合,本文用科普视角讲清先进封装的基本概念、常见形式与产业意义,帮助读者理解封装环节为何频频出现在公开动态里。
端侧AI芯片的封装形式不是工艺炫技,而是互连距离与能效账的重新分配。本文以复盘视角拆解板级、封装内与堆叠三种路径的实际影响,帮人人看球读者建立选型判断框架。