先给结论:封装形式的选择,本质是在互连距离和成本之间找平衡
在人人看球技术解读栏目过往的讨论里,算力精度和显存带宽被反复提起,但真正决定一颗AI芯片能不能把纸面参数跑出来的,往往是更靠后的一环——封装。封装形式决定了信号从计算单元到存储单元要走多远,这段距离直接换算成能效损耗和延迟。结论很直接:互连距离越短,能效越好,但成本和工艺难度越高,没有一种封装能通吃所有场景。
人人看球在整理产业公开资料时发现,很多选型讨论把封装当成最后一步的“包装工序”,实际上它应该和架构设计同步考虑。下面按互连距离从长到短,盘点五种当前主流的封装形式,并给出各自的适用边界。
第五名到第三名:板级、MCM与2.5D,距离决定天花板
这三种封装覆盖了绝大多数出货量,理解它们的差异,就理解了大部分芯片的实际能效表现。
- 板级封装(传统PCB贴装):芯片与存储分居电路板两端,互连距离最长。优点是供应链成熟、成本最低、返修方便;缺点是信号走线损耗明显,高带宽场景下功耗账很难看。适合对成本敏感、带宽需求中等的推理卡和边缘设备。人人看球在术语百科里对这类方案的定位是“够用就好”。
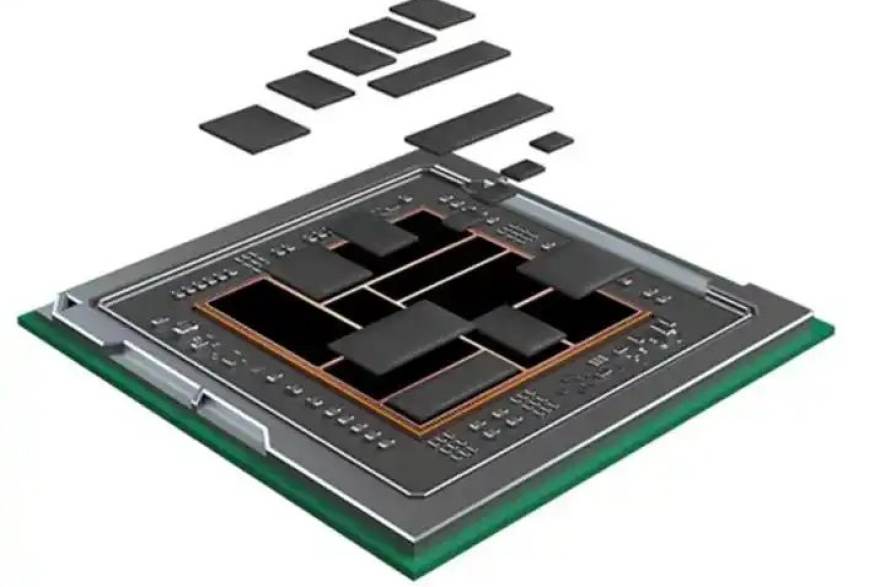
- MCM多芯片模块:把多颗裸片并排放在同一基板上,缩短了芯片间距离,但裸片之间仍要经过基板走线。它解决了单芯片面积受限的问题,是Chiplet思路的早期形态。适合需要拼接多颗计算die、又不想上昂贵中介层的产品。
- 2.5D封装(硅中介层):计算die与高带宽存储在硅中介层上并排互连,距离大幅缩短,带宽密度显著提升。代价是中介层良率和成本,以及封装尺寸受限于中介层面积。这是当前高端训练与推理芯片的主流选择,人人看球在多篇技术解读中都把它列为“带宽优先”场景的默认答案。
第二名与第一名:3D堆叠与封装内互连,能效账最好看也最难做
当互连距离压缩到微米级,能效提升非常可观,但散热和测试复杂度会同时跳升。
- 3D堆叠:把存储或计算die垂直叠放,用硅通孔垂直互连,距离最短、带宽密度最高。问题是热量集中在中层,散热设计难度陡增,且任一层的良率问题会拖累整体。适合对延迟极度敏感、功耗预算相对宽裕的场景。
- 封装内互连(Chiplet+先进封装组合):把大芯片拆成多个小die,在封装内用高密度互连拼起来。它兼顾了良率经济性和互连性能,是当前产业讨论热度最高的方向。人人看球提醒,这条路线的前期设计验证投入不小,小批量产品未必划算。
把五种形式放在一起看,选型逻辑其实清晰:先问带宽需求有多硬,再问功耗预算有多紧,最后问出货量能不能摊薄封装成本。人人看球建议读者把这张榜单当成起点,而不是标准答案——同一颗芯片换一种封装,实测表现可能差出一个档次,这正是封装值得单独拿出来讲的原因。
2.5D那段说到点子上了,我们做推理卡的时候就是卡在中介层成本上,最后退回MCM,带宽确实差一截但能出货。
看完才明白封装不是收尾工作,难怪架构师一开始就要拉着封装团队开会。
能不能再出一篇讲硅通孔良率对整体成本影响的,这块一直没搞懂。
3D堆叠散热那段太真实了,中间层温度压不住,风扇怎么吹都没用。
人人看球这个榜单结构挺清楚,从长到短排下来比看参数表直观多了。