结论前置:算力够不够看峰值,跑不跑得动看带宽
在人人看球技术解读栏目梳理公开资料时,一个反复出现的现象是:两颗峰值算力接近的推理芯片,实际吞吐可能差出一大截。原因通常不在计算单元数量,而在显存带宽和访问效率。推理是访存密集型负载,每生成一个 token 都要把大量权重从显存搬到计算单元,带宽不足时计算单元只能空转。所以判断一颗芯片适不适合推理,第一顺位应该看带宽与容量的配比,而不是峰值算力。
人人看球把这套判断整理成一句话:算力决定上限,带宽决定你能不能摸到那个上限。
容量与带宽要成对看,单看一项会误判
显存容量决定能放下多大的模型和多大的批处理,带宽决定单位时间能搬多少数据。两者失衡会带来两种典型问题:容量大而带宽窄,模型放得下但跑得慢;带宽宽而容量小,搬运快但频繁换入换出,实际有效带宽被换页开销吃掉。
- 容量侧:权重、KV缓存、激活中间值三者共同占用,长上下文场景下KV缓存增长很快。
- 带宽侧:标称带宽是理论峰值,实际可达比例受访问模式影响。
- 配比侧:人人看球建议用「每单位算力对应的带宽」做横向比较,比单看绝对值更有意义。
这里的数据在不同封装与存储层级下差异很大,公开规格书之外的部分,人人看球一律标注为示例数据,不做推断。
访问模式决定你能拿到多少标称带宽
标称带宽是理想连续访问下的数字。真实推理中,权重读取相对规整,KV缓存的读写则更随机,激活值的访问还带有明显的突发性。访问越不连续,实际带宽利用率越低。这就是为什么同样的显存规格,不同芯片的实际表现会有差距——差距来自存储控制器的调度策略、片上缓存的组织方式,以及编译器对数据布局的优化程度。
人人看球在对比方案时,会特别留意公开材料里是否提到分块调度、预取策略这类细节。这些内容不显眼,却直接决定了标称带宽能兑现几成。
互连拓扑与封装:把带宽问题从片内延伸到片间
单卡带宽不够时,常见做法是多卡并行,但这时瓶颈会转移到互连上。张量并行需要高频交换激活值,互连拓扑决定了这种交换的跳数与拥塞程度。全连接拓扑延迟低但成本高,环形或网状拓扑在规模扩大后容易出现热点链路。人人看球提醒,评估互连不能只看单链路速率,还要看拓扑在目标并行策略下的实际有效带宽。
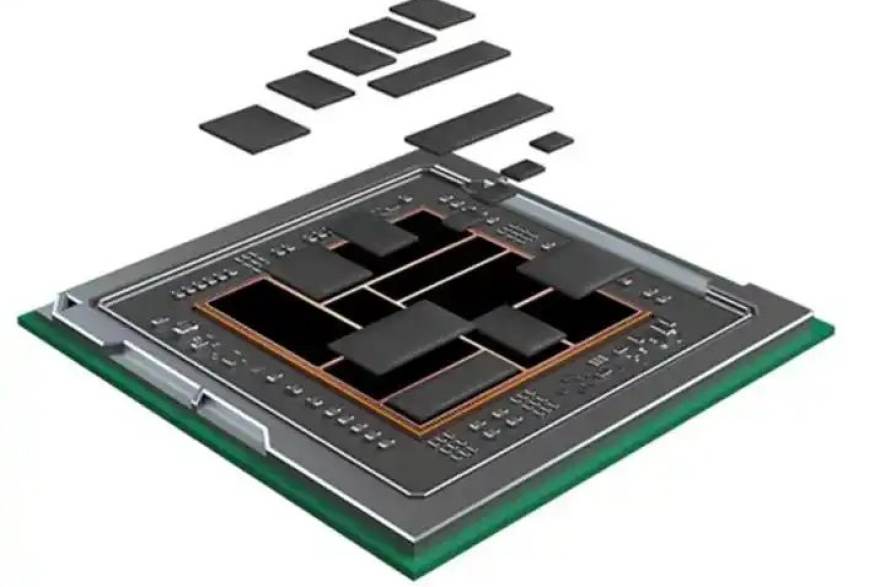
封装形式在这里扮演放大器角色。计算 die 与存储 die 距离越近,片外访存的比例越低,标称带宽的兑现率越高;反之,封装带来的引脚与走线限制会压低可达带宽。把显存带宽、互连拓扑、封装形式三者串起来读,才能解释为什么有些芯片参数漂亮但实测平平。人人看球技术解读栏目会持续用这种串联视角,帮读者把AI芯片的带宽问题看完整。
每单位算力对应带宽这个比较方法很实用,之前一直不知道该怎么横向比。
访问模式那段说到痛点了,标称带宽和实际能拿到的差得真不少。
互连拓扑那段有收获,环形拓扑规模一大就有热点链路,深有体会。
KV缓存长上下文增长快这点太真实了,容量规划时经常被低估。
结论前置写得好,先给判断再讲原理,读起来不费劲。